
Интерфейс Set, классы HashSet и LinkedHashSet в Java
Класс User переопределяет equals(), но не hashCode(). Код set.add(new User("ann")); set.add(new User("ann")); выполняется без ошибок, и set.size() возвращает 2: множество, которое «не допускает дубликатов», хранит два равных объекта. HashSet ищет элемент сначала по хеш-коду, и до equals() дело просто не доходит.
Интерфейс Set (java.util.Set<E>) описывает множество — коллекцию уникальных элементов без индексов. Он расширяет Collection, а его основные реализации — HashSet (хеш-таблица, порядок не гарантирован) и LinkedHashSet (хеш-таблица плюс связный список, порядок вставки). Попытка добавить дубликат ничего не меняет, а add() возвращает false.
Что такое интерфейс Set в Java
Set в Java — интерфейс множества: каждый элемент хранится не больше одного раза, доступа по индексу нет, а порядок обхода задаёт конкретная реализация. Новых абстрактных методов по сравнению с Collection он не добавляет, но уточняет их контракт: add() не добавляет элемент, который уже есть.
Как именно определяется «тот же элемент», зависит от реализации:
HashSetиLinkedHashSetсравнивают элементы черезhashCode()иequals(), поэтому в своих классах нужно переопределять оба метода (раздел Контракт hashCode() и equals());TreeSetсравнивает элементы черезcompareTo()илиComparatorи хранит их отсортированными — это тема урока SortedSet и TreeSet.
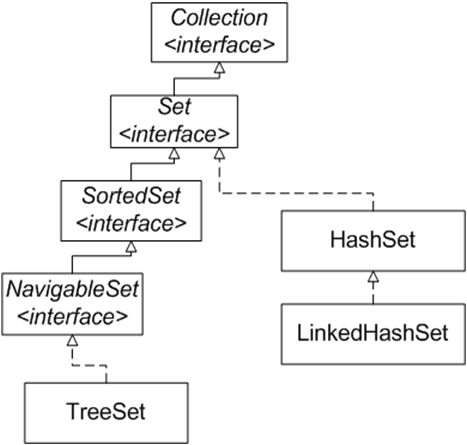
Кроме методов Collection, в интерфейсе есть статические фабрики Set.of(...) (Java 9) и Set.copyOf(...) (Java 10) — они создают неизменяемое множество. Ниже показана ветка иерархии коллекций, которая начинается с Set:
Место Set среди остальных коллекций и сводная таблица «какую реализацию выбрать» — в уроке Коллекции в Java, а множество как структура данных без привязки к Java — в уроке Структуры данных.
Методы Set и HashSet
Основные методы HashSet — add(), remove(), contains(), size(), isEmpty(), clear() и iterator(); все они объявлены в Collection. Для множества важны ещё три групповых метода: addAll() даёт объединение, retainAll() — пересечение, removeAll() — разность множеств.
| Метод | Что делает в Set | Граничный случай |
|---|---|---|
boolean add(E e) | Добавляет элемент, если такого ещё нет | Дубликат — false, множество не меняется |
boolean remove(Object o) | Удаляет элемент | Элемента нет — false, исключения нет |
boolean contains(Object o) | Проверяет наличие за O(1) в среднем | Для своего класса без hashCode() вернёт false для «равного» объекта |
int size(), boolean isEmpty() | Количество элементов / пусто ли множество | Дубликаты не учитываются: их в множестве нет |
void clear() | Удаляет все элементы | Внутренняя таблица не уменьшается |
boolean addAll(Collection c) | Объединение: добавляет элементы c, которых ещё нет | true, если добавился хотя бы один |
boolean retainAll(Collection c) | Пересечение: оставляет только элементы, которые есть в c | retainAll(Set.of()) очищает множество |
boolean removeAll(Collection c) | Разность: удаляет элементы, которые есть в c | Отсутствующие в множестве элементы c игнорируются |
boolean containsAll(Collection c) | Проверяет, является ли c подмножеством | Для пустой c — всегда true |
Iterator<E> iterator(), forEach() | Обход элементов | У HashSet порядок не гарантирован, у LinkedHashSet — порядок вставки |
static Set.of(...), Set.copyOf(c) | Неизменяемое множество (Java 9 / 10) | add() — UnsupportedOperationException; null — NullPointerException |
Групповые методы меняют множество, у которого вызваны, поэтому для операций над множествами сначала делают копию:
import java.util.HashSet;
import java.util.List;
import java.util.Set;

public class SetOperationsExample {
    public static void main(String[] args) {
        Set<Integer> a = new HashSet<>(List.of(1, 2, 3, 4));
        Set<Integer> b = Set.of(3, 4, 5);

        Set<Integer> union = new HashSet<>(a);
        union.addAll(b);
        Set<Integer> intersection = new HashSet<>(a);
        intersection.retainAll(b);
        Set<Integer> difference = new HashSet<>(a);
        difference.removeAll(b);

        System.out.println("Объединение: " + union);
        System.out.println("Пересечение: " + intersection);
        System.out.println("Разность: " + difference);
        System.out.println("a не изменилось: " + a);
        System.out.println(a.containsAll(Set.of(1, 2)));
    }
}
Вывод:
Объединение: [1, 2, 3, 4, 5]
Пересечение: [3, 4]
Разность: [1, 2]
a не изменилось: [1, 2, 3, 4]
true
Числа здесь вывелись по возрастанию случайно: у маленьких Integer номер бакета совпадает со значением. Почему на других данных порядок будет другим, показано в разделе Пример HashSet. Подробные таблицы всех методов Collection — в уроке Интерфейс Collection.
Что такое HashSet и как он устроен
HashSet в Java — это реализация Set на основе хеш-таблицы: по хеш-коду элемента вычисляется номер ячейки (бакета), куда элемент кладётся и где его потом ищут. Благодаря этому add(), contains() и remove() работают в среднем за постоянное время, но порядок элементов не гарантирован.
Внутри HashSet лежит обычный HashMap: элементы множества хранятся как его ключи, а значением для всех ключей служит один общий объект-заглушка. Поэтому правила для элементов HashSet те же, что для ключей HashMap, и HashSet допускает один null.
Хеш-код и бакеты
Хеш-код — целое число, которое метод hashCode() вычисляет по содержимому объекта. Его можно считать «адресом» объекта в таблице, но не уникальным ID: у разных объектов хеш-коды могут совпадать. Рассмотрим учебный алгоритм: каждой букве ключа сопоставим её номер в алфавите и сложим номера.
| Ключ | Алгоритм хеш-кода | Хеш-код (номер бакета) |
|---|---|---|
| Alex | A(1) + l(12) + e(5) + x(24) | 42 |
| Bob | B(2) + o(15) + b(2) | 19 |
| Dirk | D(4) + i(9) + r(18) + k(11) | 42 |
| Fred | F(6) + r(18) + e(5) + d(4) | 33 |
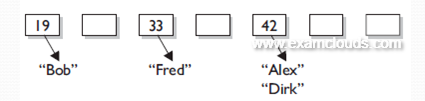
«Bob» попадает в бакет 19, «Fred» — в бакет 33, а у «Alex» и «Dirk» одинаковый хеш-код 42, и оба оказываются в одном бакете. Такая ситуация называется коллизией, и она допустима. Настоящий String.hashCode() считается по-другому (s[0]*31^(n-1) + ... + s[n-1]), а HashSet дополнительно сжимает хеш-код до номера бакета: (h ^ (h >>> 16)) & (capacity - 1). Идея при этом та же.
Поиск идёт в обратном порядке: по элементу вычисляется хеш-код, по нему — бакет. Если в бакете несколько элементов, нужный выбирается методом equals(). Поэтому HashSet зависит от обоих методов: hashCode() выбирает бакет, equals() находит элемент внутри него.
Контракт hashCode() и equals()
Контракт hashCode() и equals() — это правило, без которого HashSet и HashMap работают неправильно: равные по equals() объекты обязаны возвращать одинаковый hashCode(). Если переопределить только equals(), равные объекты окажутся в разных бакетах, и множество примет дубликат.
Полностью контракт из документации Object звучит так:
- Пока не изменились поля, которые участвуют в
equals(),hashCode()одного и того же объекта возвращает одно и то же число (в рамках одного запуска программы). - Если
a.equals(b), тоa.hashCode() == b.hashCode(). - Обратное неверно: одинаковые хеш-коды не означают, что объекты равны (это коллизия).
- Как следствие пункта 2: если хеш-коды разные, объекты гарантированно не равны.
Вот пример из начала урока целиком — и его исправление:
import java.util.HashSet;
import java.util.Objects;
import java.util.Set;

public class HashCodeExample {
    static class User {
        private final String login;
        User(String login) { this.login = login; }

        @Override
        public boolean equals(Object o) {
            return o instanceof User u && login.equals(u.login);
        }
        // hashCode() не переопределён
    }

    static class FixedUser {
        private final String login;
        FixedUser(String login) { this.login = login; }

        @Override
        public boolean equals(Object o) {
            return o instanceof FixedUser u && login.equals(u.login);
        }

        @Override
        public int hashCode() {
            return Objects.hash(login);
        }
    }

    public static void main(String[] args) {
        Set<User> users = new HashSet<>();
        users.add(new User("ann"));
        users.add(new User("ann"));
        System.out.println(users.size());
        System.out.println(users.contains(new User("ann")));

        Set<FixedUser> fixed = new HashSet<>();
        fixed.add(new FixedUser("ann"));
        System.out.println(fixed.add(new FixedUser("ann")));
        System.out.println(fixed.size());
        System.out.println(fixed.contains(new FixedUser("ann")));
    }
}
Вывод:
2
false
false
1
true
Без hashCode() используется версия из Object, которая у разных объектов почти всегда даёт разные числа. Два «равных» пользователя попадают в разные бакеты, equals() не вызывается, и в множестве оказываются оба. С Objects.hash(login) второй add() находит существующий элемент и возвращает false.
Формально корректна и такая реализация — она не нарушает ни одного пункта контракта:
@Override
public int hashCode() {
    return 1;
}
Но все объекты класса окажутся в одном бакете, и HashSet потеряет главное преимущество: поиск станет линейным. Хорошая функция распределяет объекты по бакетам равномерно. Придумывать её самому не нужно: hashCode() и equals() генерирует IntelliJ IDEA (Code → Generate → equals() and hashCode()), можно использовать Objects.hash(...), а record (Java 16) создаёт оба метода автоматически. Подробнее о самом методе — в уроке Метод equals().
Конструкторы HashSet: initialCapacity и loadFactor
У HashSet четыре конструктора и, начиная с Java 19, фабричный метод HashSet.newHashSet(int). Параметры initialCapacity (начальное число бакетов) и loadFactor (допустимая заполненность таблицы) определяют, когда таблица будет перестроена.
| Конструктор / метод | Что создаёт | Граничный случай |
|---|---|---|
HashSet() | Пустое множество: ёмкость 16, loadFactor 0,75 | Таблица выделяется при первом add() |
HashSet(int initialCapacity) | Заданная ёмкость, loadFactor 0,75 | Отрицательная ёмкость — IllegalArgumentException |
HashSet(int initialCapacity, float loadFactor) | Заданные ёмкость и коэффициент загрузки | loadFactor ≤ 0 или NaN — IllegalArgumentException |
HashSet(Collection<? extends E> c) | Множество из элементов c, дубликаты отбрасываются | c == null — NullPointerException |
static HashSet.newHashSet(int numElements) | Множество, рассчитанное на numElements элементов без перестройки (Java 19) | Отрицательное значение — IllegalArgumentException |
Начальная ёмкость (initial capacity) — количество бакетов в хеш-таблице. Ёмкость всегда округляется вверх до степени двойки: new HashSet<>(100) создаст таблицу на 128 бакетов.
Коэффициент загрузки (load factor) показывает, насколько заполненной может стать таблица. Когда число элементов становится больше capacity * loadFactor, происходит рехеширование: создаётся таблица вдвое большего размера, и все элементы раскладываются по новым бакетам. Для ёмкости 16 и коэффициента 0,75 это случится при добавлении 13-го элемента.
Значение 0,75 — компромисс между памятью и скоростью. Если коэффициент увеличить, таблица реже растёт и занимает меньше памяти, но в бакетах становится больше коллизий, и поиск замедляется. Если уменьшить — поиск быстрее, но памяти тратится больше.
Ёмкость — не количество элементов
Вызов new HashSet<>(100) не означает «влезет 100 элементов без перестройки»: таблица на 128 бакетов при коэффициенте 0,75 вырастет на 97-м элементе. Чтобы заранее выделить место ровно под 100 элементов, на Java 19+ используйте HashSet.newHashSet(100) (для LinkedHashSet — LinkedHashSet.newLinkedHashSet(100)), а на более старых версиях передайте ёмкость (int) (100 / 0.75f) + 1.
Производительность HashSet: O(1) и худший случай
Операции add(), contains() и remove() у HashSet выполняются в среднем за O(1) — время почти не зависит от размера множества, если хеш-коды распределены равномерно. size() и isEmpty() всегда O(1): размер хранится в отдельном поле.
Худший случай — когда все элементы попадают в один бакет (например, при hashCode(), который возвращает константу). До Java 8 бакет был связным списком, и поиск в нём занимал O(n). Начиная с Java 8 бакет, в котором набралось 8 и больше элементов, превращается в красно-чёрное дерево (если в таблице не меньше 64 бакетов; иначе таблица просто увеличивается), и поиск в худшем случае занимает O(log n). Лучше всего это работает, когда элементы реализуют Comparable.
Перебор HashSet занимает время, пропорциональное сумме размера и ёмкости: итератор проходит и пустые бакеты. Если создать множество с огромной ёмкостью ради нескольких элементов, обход станет медленным.
Пример HashSet: в каком порядке выводятся элементы
HashSet выводит элементы в порядке бакетов, а не в порядке добавления и не по возрастанию. Для небольших положительных Integer хеш-код равен самому числу, поэтому номер бакета в таблице на 16 ячеек — это остаток от деления на 16. Что выведет этот код?
import java.util.HashSet;
import java.util.Set;

public class HashSetExample {
    public static void main(String[] args) {
        Set<Integer> numbers = new HashSet<>();
        numbers.add(30);
        numbers.add(5);
        numbers.add(17);
        numbers.add(1);

        System.out.println(numbers.add(30));
        System.out.println(numbers);
        System.out.println(numbers.contains(5));

        numbers.remove(17);
        numbers.add(null);
        System.out.println(numbers);
        System.out.println(numbers.size());
    }
}
Вывод:
false
[17, 1, 5, 30]
true
[null, 1, 5, 30]
4
Повторный add(30) вернул false. Число 30 попало в бакет 14, 5 — в бакет 5, а 17 и 1 — оба в бакет 1 (17 % 16 = 1), где лежат в порядке добавления. Отсюда [17, 1, 5, 30]: не порядок вставки и не сортировка. null разрешён и всегда попадает в бакет 0, поэтому выводится первым.
Порядок HashSet может измениться сам
Порядок обхода HashSet зависит от ёмкости таблицы, поэтому после рехеширования он меняется: добавьте в пример выше ещё 9 чисел, и таблица вырастет до 32 бакетов, а 17 и 1 окажутся в разных бакетах. Порядок может отличаться и между версиями Java. Тесты, которые сравнивают set.toString() со строкой, рано или поздно ломаются — сравнивайте множества через equals() или используйте LinkedHashSet.
Что такое LinkedHashSet
LinkedHashSet в Java — это подкласс HashSet, который дополнительно связывает элементы двусвязным списком и поэтому перебирает их в порядке вставки. Скорость операций остаётся O(1) в среднем, как у HashSet, но каждый элемент занимает больше памяти.
Внутри LinkedHashSet использует LinkedHashMap. Повторное добавление уже существующего элемента не меняет его позицию: add() просто возвращает false.
import java.util.LinkedHashSet;
import java.util.Set;

public class LinkedHashSetExample {
    public static void main(String[] args) {
        Set<String> set = new LinkedHashSet<>();

        set.add("Бета");
        set.add("Альфа");
        set.add("Эта");
        set.add("Гамма");
        set.add("Эпсилон");
        set.add("Омега");

        System.out.println(set.add("Альфа"));
        System.out.println(set);
    }
}
Вывод:
false
[Бета, Альфа, Эта, Гамма, Эпсилон, Омега]
Самое частое практическое применение — убрать дубликаты из списка, сохранив порядок первых вхождений:
List<String> tags = List.of("java", "sql", "java", "git", "sql");
List<String> unique = new ArrayList<>(new LinkedHashSet<>(tags));
System.out.println(unique); // Вывод: [java, sql, git]
С HashSet вместо LinkedHashSet дубликаты тоже исчезнут, но порядок тегов станет произвольным.
LinkedHashSet в Java 21: getFirst(), addFirst(), reversed()
В Java 21 LinkedHashSet реализует новый интерфейс SequencedSet и получил методы getFirst(), getLast(), addFirst(), addLast(), removeFirst(), removeLast() и reversed(). В отличие от add(), методы addFirst() и addLast() перемещают уже существующий элемент в начало или конец.
LinkedHashSet<String> recent = new LinkedHashSet<>(List.of("a", "b", "c"));

System.out.println(recent.add("a"));   // false, порядок не изменился
System.out.println(recent);            // [a, b, c]
recent.addLast("a");                   // Java 21: "a" переезжает в конец
System.out.println(recent);            // [b, c, a]
System.out.println(recent.getFirst() + " " + recent.reversed());  // b [a, c, b]
Переменная должна иметь тип LinkedHashSet или SequencedSet: у интерфейса Set этих методов нет. На Java 17 код не скомпилируется — там первый элемент берут через iterator().next(). Общая схема Sequenced-интерфейсов — в уроке Иерархия коллекций.
LinkedHashSet vs HashSet: в чём разница
Разница между LinkedHashSet и HashSet одна по сути — порядок обхода: LinkedHashSet гарантирует порядок вставки, HashSet не гарантирует никакого. За порядок LinkedHashSet платит памятью (две дополнительные ссылки на каждый элемент) и немного более медленными вставками и удалениями.
| Признак | HashSet | LinkedHashSet |
|---|---|---|
| Порядок обхода | Не гарантирован, меняется после рехеширования | Порядок вставки |
| Внутри | HashMap | LinkedHashMap: хеш-таблица + двусвязный список |
add(), contains(), remove() | O(1) в среднем | O(1) в среднем, немного медленнее из-за поддержки списка |
| Перебор | Пропорционален размеру + ёмкости | Пропорционален только размеру |
| Память | Меньше | Больше: ссылки на предыдущий и следующий элемент |
null | Один | Один |
| Методы Java 21 | Только методы Set | SequencedSet: getFirst(), addLast(), reversed() |
| Когда выбирать | Порядок не важен — выбор по умолчанию | Нужен предсказуемый порядок: вывод пользователю, удаление дубликатов из списка |
Если элементы нужны не в порядке вставки, а отсортированными, подходит третья реализация — TreeSet с операциями за O(log n). Чем «упорядоченная» коллекция отличается от «отсортированной», разобрано в разделе Упорядоченные и отсортированные коллекции.
Часто задаваемые вопросы
Как получить элемент HashSet по индексу?
Никак: у Set нет метода get(int), потому что у элементов множества нет позиций. Элементы перебирают циклом for-each или через stream(), а если индекс действительно нужен, копируют множество в список: new ArrayList<>(set).get(0). Для HashSet «нулевой» элемент при этом заранее не определён; предсказуемый первый элемент даёт LinkedHashSet — на Java 21 через getFirst().
Чем Set.of() отличается от new HashSet<>()?
Set.of() создаёт неизменяемое множество: add() и remove() бросают UnsupportedOperationException, null запрещён. Неочевидная деталь: повторяющийся аргумент, например Set.of("a", "a"), бросает IllegalArgumentException: duplicate element: a, а не отбрасывается, как в HashSet. Кроме того, порядок обхода Set.of() может меняться от запуска к запуску программы.
Что будет, если изменить объект после добавления в HashSet?
Если меняется поле, от которого зависит hashCode(), объект остаётся в старом бакете, а ищется уже в новом: contains() вернёт false, remove() не удалит элемент, а повторный add() добавит «дубликат». Поэтому элементами HashSet делают неизменяемые объекты: String, Integer, record. Та же ситуация с ключами разобрана в уроке Map: свойства ключей.
Потокобезопасен ли HashSet?
Нет: при одновременной записи из нескольких потоков элементы могут теряться, а итератор бросает ConcurrentModificationException. Потокобезопасное множество на хеш-таблице создают через ConcurrentHashMap.newKeySet(); обёртка Collections.synchronizedSet(new HashSet<>()) тоже работает, но блокирует всё множество на каждую операцию. Обзор многопоточных коллекций — в разделе Потокобезопасные коллекции.
Практика по теме
Закрепите урок на задачах — у каждой есть уровень и оценка времени.
- Удаление повторяющихся чисел из строки через Set
- Объединение и пересечение множеств: union() и intersect()
- Студенты: фильтрация по среднему баллу и перевод на курс
Видео объяснение
Предпочитаете видеоформат? Посмотрите этот урок с примерами и объяснениями.
Комментарии