Потоки данных (stream) в Java: ввод-вывод и упаковка потоков
Программа записала отчёт через BufferedWriter, завершилась без единого исключения — а файл report.txt пустой, 0 байт:
BufferedWriter writer = new BufferedWriter(new FileWriter("report.txt"));
writer.write("Итого: 42");
// close() не вызван, программа завершилась
// Результат: report.txt создан, но его размер 0 байт
Строка осталась в буфере обёртки и так и не дошла до файла. Почему так происходит и какой поток в цепочке нужно закрывать — разберём ниже, начиная с самого понятия потока.
Поток данных (stream) в Java — это упорядоченная последовательность байтов или символов, которая передаётся между программой и источником (source) или приёмником (destination) данных: файлом, консолью, сетевым соединением, массивом в памяти. Потоки бывают входные (читают данные) и выходные (записывают данные), байтовые и символьные; их классы находятся в пакете java.io.
Что такое поток данных в Java
Поток данных в Java — это абстракция ввода-вывода: программа читает или записывает данные по очереди, элемент за элементом, не зная, какое физическое устройство стоит на другом конце. Поток ввода связан с источником данных, поток вывода — с приёмником.
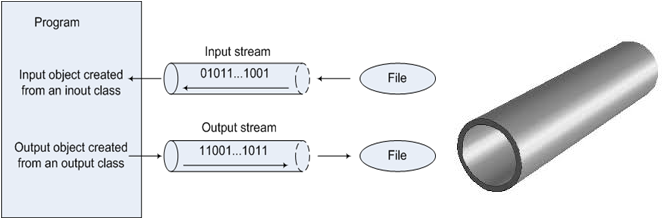
В информатике потоком вообще называют последовательность данных, которая становится доступна постепенно, а не целиком сразу. В Java потоки ввода-вывода реализованы иерархией классов, определённых в пакете java.io. Эти классы избавляют от необходимости разбираться в низкоуровневом устройстве операционной системы: программа работает с файлом, клавиатурой или сетью через одни и те же методы read() и write().
Все потоки ввода-вывода ведут себя одинаково, независимо от конкретного устройства. Один и тот же код, читающий из InputStream, сможет читать из файла на диске, из сетевого сокета или из стандартного ввода System.in (о нём — в уроке Предопределенные потоки ввода-вывода). Поток читается последовательно: прочитанный байт «уходит», и вернуться к нему без специальных классов нельзя.
I/O-потоки, Stream API и Thread: три разных «потока»
В русскоязычной литературе словом «поток» называют три разные вещи в Java: поток ввода-вывода (java.io.InputStream и др.), поток Stream API (java.util.stream.Stream, Java 8) и поток выполнения (java.lang.Thread, см. многопоточность в Java). Этот урок — только о первом: о передаче байтов и символов.
| «Поток» | Классы | Что это | Пример |
|---|---|---|---|
| Поток ввода-вывода (I/O stream) | InputStream, OutputStream, Reader, Writer (java.io) | Последовательность байтов или символов между программой и файлом, консолью, сетью | new FileInputStream("photo.jpg") |
| Stream API | Stream<T>, IntStream (java.util.stream, с Java 8) | Конвейер операций над элементами коллекции или массива; ничего не читает с диска сам по себе | list.stream().filter(s -> s.isEmpty()).count() |
| Поток выполнения (thread) | Thread, Runnable (java.lang) | Отдельная ветка выполнения кода, работающая параллельно с другими | new Thread(task).start() |
Названия пересекаются, но связи между ними нет: FileInputStream не наследует Stream и не запускает отдельный Thread. Единственная точка соприкосновения — метод BufferedReader.lines(), который превращает строки из I/O-потока в Stream<String>.
Виды потоков: байтовые и символьные, ввода и вывода
Потоки в Java делятся по двум признакам: по типу данных — на байтовые и символьные, по направлению — на потоки ввода (input) и вывода (output). Сочетание признаков даёт четыре основных абстрактных класса: InputStream, OutputStream, Reader и Writer.
По типу данных в Java существует 2 вида потоков:
- Байтовые потоки (binary streams) передают байты — восьмибитные значения. Подходят для любых данных: изображений, архивов, аудио, сериализованных объектов.

- Символьные потоки (text streams) передают символы
char— 16-битные единицы Unicode (UTF-16). Подходят для текста.

Важно понимать: в файле или в сети всегда лежат байты. Символьный поток — это байтовый поток плюс кодировка, которая переводит байты в символы и обратно (подробнее — в разделе Цепочка обёрток).
По направлению потоки делятся на потоки ввода (input) и потоки вывода (output). В Java определены четыре основных абстрактных класса для работы с потоками:
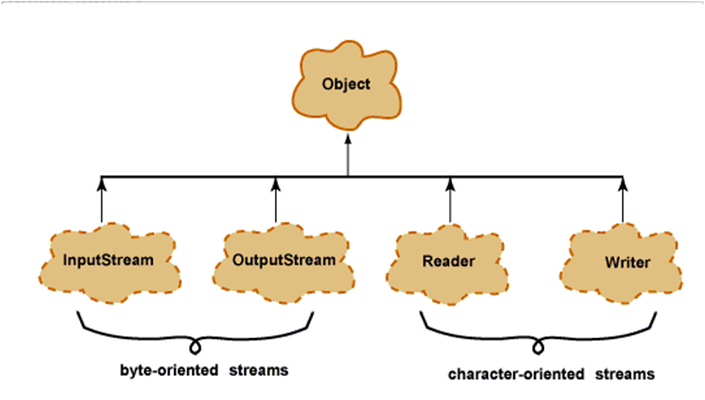
| Направление | Байтовые потоки | Символьные потоки | Пример наследника |
|---|---|---|---|
| Ввод (чтение) | InputStream | Reader | FileInputStream, FileReader |
| Вывод (запись) | OutputStream | Writer | FileOutputStream, FileWriter |
По имени класса легко определить его вид: суффикс ...Stream — байтовый, ...Reader/...Writer — символьный. Методы и конкретные классы разобраны в уроках Типы байтовых потоков в Java и Классы символьных потоков.
Общая схема работы с потоками
Работа с любым потоком ввода-вывода в Java сводится к трём шагам: открыть поток, связанный с источником или приёмником, читать или писать данные, пока они есть, и закрыть поток, чтобы освободить ресурс операционной системы и сбросить буферы.
- Создать потоковый объект и связать его с источником или приёмником данных (файлом на диске, сокетом, массивом).
- Пока есть информация, читать данные из потока или записывать данные в поток.
- Закрыть поток.
В современном коде третий шаг выполняет конструкция try-with-resources (Java 7+): поток закрывается автоматически, даже если внутри возникло исключение. Скелет любой работы с потоком выглядит так:
try (InputStream in = new FileInputStream("data.bin")) { // 1. открыть
    int b;
    while ((b = in.read()) != -1) {                       // 2. читать, пока не -1
        // обработать байт b
    }
}                                                         // 3. close() вызовется сам
Подробно конструкция разобрана в уроке Конструкция try-with-resources.
Упаковка (wrapping) потоков: паттерн «декоратор»
Упаковка (wrapping) потоков — это приём, при котором один поток передаётся в конструктор другого и получает от него новые возможности: буферизацию, чтение строк, форматированный вывод, перевод байтов в символы. Внешний поток называют обёрткой; он делегирует реальное чтение и запись внутреннему потоку.
Иначе говоря, потокам можно придать новые свойства, заключив один поток в оболочку другого. По-другому это называется упаковкой (wrapping) классов. В основе лежит паттерн проектирования «декоратор»: обёртка имеет тот же тип, что и оборачиваемый поток (BufferedReader — тоже Reader), поэтому обёртки можно вкладывать друг в друга в любом нужном порядке, не создавая отдельный класс под каждую комбинацию.
Класс BufferedReader применяют для более эффективного чтения символов, массивов и строк:
BufferedReader reader = new BufferedReader(new FileReader("input.txt"));Классы BufferedWriter и PrintWriter используют для более эффективной записи символов, массивов, строк и других типов данных:
BufferedWriter writer = new BufferedWriter(new FileWriter("report.txt"));
PrintWriter printer = new PrintWriter(new BufferedWriter(new FileWriter("log.txt")));
В последней строке три уровня: FileWriter пишет в файл, BufferedWriter копит символы в буфере и отдаёт их крупными порциями, PrintWriter добавляет удобные println() и printf(). Основные обёртки java.io:
| Обёртка | Что оборачивает | Что добавляет | Нюанс |
|---|---|---|---|
BufferedInputStream / BufferedOutputStream | InputStream / OutputStream | Буфер 8192 байта: меньше обращений к диску | Без flush()/close() записанное остаётся в буфере |
BufferedReader | Reader | Буфер 8192 символа и метод readLine() | readLine() возвращает null в конце потока, символ перевода строки отбрасывается |
BufferedWriter | Writer | Буфер и метод newLine() | Данные попадают в файл только при заполнении буфера, flush() или close() |
PrintWriter | Writer или OutputStream | print(), println(), printf() | Не бросает IOException: ошибку записи узнают только через checkError() |
InputStreamReader | InputStream | Мост байты → символы с заданной кодировкой | Без явного Charset берётся кодировка по умолчанию |
OutputStreamWriter | OutputStream | Мост символы → байты с заданной кодировкой | То же: кодировку лучше указывать явно |
Конструкторы и методы буферизованных классов и PrintWriter с примерами — в уроке Классы символьных потоков.
Цепочка обёрток: от байтов к строкам
Чтобы читать текстовый файл построчно в нужной кодировке, байтовый поток оборачивают в InputStreamReader (мост от байтов к символам), а его — в BufferedReader (буфер и readLine()). Для записи цепочка зеркальная: FileOutputStream → OutputStreamWriter → BufferedWriter → PrintWriter.
Пример: программа записывает две строки в файл в кодировке UTF-8 через цепочку из четырёх потоков, а затем читает их обратно через цепочку из трёх.
import java.io.*;
import java.nio.charset.StandardCharsets;

public class WrappingDemo {
    public static void main(String[] args) throws IOException {
        // Запись: PrintWriter -> BufferedWriter -> OutputStreamWriter -> FileOutputStream
        try (PrintWriter printer = new PrintWriter(
                new BufferedWriter(
                        new OutputStreamWriter(
                                new FileOutputStream("notes.txt"), StandardCharsets.UTF_8)))) {
            printer.println("Привет, поток!");
            printer.printf("%d + %d = %d%n", 2, 3, 2 + 3);
        }

        // Чтение: BufferedReader -> InputStreamReader -> FileInputStream
        try (BufferedReader reader = new BufferedReader(
                new InputStreamReader(
                        new FileInputStream("notes.txt"), StandardCharsets.UTF_8))) {
            String line;
            int number = 1;
            while ((line = reader.readLine()) != null) {
                System.out.println(number++ + ": " + line);
            }
        }
    }
}
Вывод программы:
1: Привет, поток!
2: 2 + 3 = 5
Каждое звено отвечает ровно за одно: FileOutputStream знает только про байты и файл, OutputStreamWriter — про кодировку, BufferedWriter — про буфер, PrintWriter — про форматирование. Если в файле окажется не UTF-8, а, например, windows-1251, достаточно поменять один аргумент Charset.
Кодировка по умолчанию
Если не указать Charset, FileReader, FileWriter и InputStreamReader используют кодировку по умолчанию. До Java 17 включительно она зависела от ОС (на русской Windows — windows-1251), поэтому файл в UTF-8 читался «кракозябрами». С Java 18 (JEP 400) по умолчанию везде UTF-8. Начиная с Java 11 у FileReader и FileWriter есть конструкторы с параметром Charset — явная кодировка делает код одинаковым на любой версии и ОС.
Какую обёртку закрывать
Закрывать нужно только самую внешнюю обёртку: её метод close() сначала сбрасывает свой буфер (flush()), а затем закрывает вложенный поток, тот — следующий, и так до файла. Закрытие внутреннего потока вместо внешнего — одна из частых ошибок: данные из буфера обёртки теряются.
Что выведет этот код и что окажется в файле?
FileWriter fileWriter = new FileWriter("log.txt");
BufferedWriter writer = new BufferedWriter(fileWriter);
writer.write("строка");
fileWriter.close();   // закрыли внутренний поток
writer.close();       // пытаемся закрыть обёртку
Результат: файл log.txt пустой, а writer.close() бросает java.io.IOException: Stream closed. Строка «строка» лежала в буфере BufferedWriter; при закрытии обёртка пытается сбросить её во внутренний поток, а тот уже закрыт. Ровно поэтому пустым остался и report.txt из примера в начале урока: там close() не вызвали вовсе, и буфер не был сброшен.
Исправление — закрывать внешнюю обёртку, лучше всего через try-with-resources:
try (BufferedWriter writer = new BufferedWriter(new FileWriter("log.txt"))) {
    writer.write("строка");
} // writer.close(): flush() буфера, затем FileWriter.close()
// Результат: в log.txt записано «строка»
Неочевидный момент
В записи new InputStreamReader(new FileInputStream(f), "UTF8x") файл уже открыт, когда конструктор обёртки бросает UnsupportedEncodingException, и FileInputStream никто не закроет. Если конструктор обёртки может упасть, объявляйте каждое звено отдельным ресурсом: try (FileInputStream in = new FileInputStream(f); InputStreamReader r = new InputStreamReader(in, cs)) — try-with-resources закроет их в обратном порядке.
Часто задаваемые вопросы
Можно ли скопировать картинку или zip-архив через FileReader и FileWriter?
Нет. Символьные потоки декодируют байты в символы по кодировке, и последовательности байтов, недопустимые для неё, заменяются символом-заменителем — файл окажется повреждённым. Двоичные данные копируют байтовыми потоками FileInputStream/FileOutputStream (см. урок Типы байтовых потоков).
Где в java.io видно, что обёртки — это паттерн «декоратор»?
В базовых классах FilterInputStream, FilterOutputStream, FilterReader и FilterWriter: они хранят ссылку на вложенный поток и по умолчанию передают ему все вызовы. От FilterInputStream наследуются, например, BufferedInputStream и DataInputStream. Как обёртки складываются в цепочку — в разделе Упаковка (wrapping) потоков.
Когда вызывать flush(), если есть close()?
close() сам вызывает flush(), поэтому в конце работы отдельный вызов не нужен. flush() нужен, когда поток остаётся открытым, а данные должны дойти до приёмника сразу: запись лога в долго работающей программе, ответ по сети, вывод прогресса.
Чем java.io отличается от java.nio?
java.io построен на потоках и блокирующих вызовах read()/write(). java.nio (Java 1.4) добавил каналы, буферы и неблокирующий ввод-вывод, а NIO.2 (Java 7) — классы Path и Files. При этом Files.newBufferedReader(path) возвращает обычный BufferedReader в UTF-8, так что знание потоков java.io нужно и при работе с NIO.
Comments